11 de dezembro de 2014

Tipos de dados no Redis

       Nesse post será discutido um pouco mais sobre o Redis, mais precisamente à respeito de como ele trata alguns tipos de valores. A tabela abaixo traz um resumo dos tipos de dados do Redis.

Fonte: http://mariuszprzydatek.files.wordpress.com/2013/08/redis-data-types.png
  • Strings:
      São o tipo mais básico de valor no Redis. Uma String no Redis pode conter qualquer tipo de dado, desde uma imagem JPEG até um objeto Ruby serializado por exemplo, pode ter até 512MB de tamanho em comprimento. Assim como em linguagens de programação como JAVA ou C++, há no Redis diversas funções para o manejo de Strings, como:
      - APPEND -> Usado para concatenar Strings;
      - GET -> Obtém o valor da chave.
      - MGET -> Obtém uma lista de valores a partir de uma lista de chaves.
      Uma lista completa de comandos para manejar Strings pode ser encontrado aqui. Segue imagem ilustrativa para os exemplos citados:

Ambiente de testes do blog mvjufs

  • Lists:
      São apenas listas de Strings. É possível adicionar elementos tanto no início (head) quanto no final (tail) da lista. O tamanho máximo de uma lista é de 232 - 1 elementos (4294967295, mais do que 4 bilhões de elementos por lista). A figura abaixo ilustra como adicionar elementos ao início da lista com LPUSH, obter o tamanho com LLEN, buscar um item com LINDEX e listar uma range de valores com LRANGE, outros comandos para manejar listas podem ser encontrados aqui.
Ambiente de testes do blog mvjufs
      Por enquanto é só, num próximo post traremos mais postagens acerca dos demais tipos de dados do Redis.

Referências:
Redis Data Types. Disponível em <http://redis.io/topics/data-types>. Acesso em 10/12/2014.

5 de dezembro de 2014

Importância do NoSQL nas Organizações

    Iremos abordar nesse post a relevância do NoSQL nas organizações, quando é válido o seu uso e quando não é aconselhável.

    A maioria das soluções de sistemas de informação fazem uso de um banco de dados para gerenciamento de informação, mas como saber quando é indicado o uso de um banco de dados relacional ou um banco de dados NoSQL?


Fonte: http://blog.izenda.com/wp-content/uploads/2013/05/SQL-600x309.png

    Com o aumento do fluxo de dados e necessidade do uso de dados mais complexos em aplicações atuais, que não poderiam ser tratados de forma nativa por bancos relacionais, surgiu O NoSQL  para tratar de problemas desse tipo.

    Por exemplo, em sistemas de informações comuns, que não operam em grandes volumes de dados não é indicado o uso do NoSQL. O uso de NoSQL não traria ganhos significativos em aplicações como: RP's, controle de estoque, fluxo de caixa, entre muitas outras soluções.

     Em contrapartida, há casos em que aplicar a tecnologia não-relacional melhora eficiência e performance de determinadas aplicações. Soluções que geram número elevado de dados, ou ainda, usam tipos de dados incomuns, terão uma fluidez maior.

    Como exemplo de organizações que fazem uso de projetos não-relacionais temos o Facebook, o eBay, Google, Netflix, entre muitas outra organizações de nível e uso mundiais.

Banco de dados NoSQL Orientado a Grafos

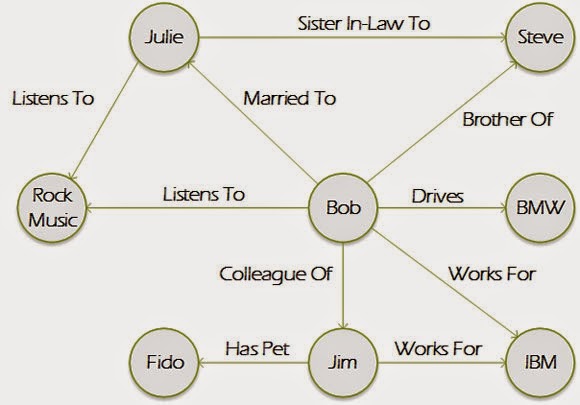
Representação de um banco de dados orientado a grafos
(Fonte: http://www.computerweekly.com/feature/Whiteboard-it-the-power-of-graph-databases)


      Neste post iremos apresentar mais um tipo de modelo de dados NoSQL, que são os banco de dados orientado a grafos.

      Os banco de dados orientado a grafos foram desenvolvidos a partir do ramo da matemática conhecido como teoria dos grafos, que se originou no século XVIII pelo matemático Leonhard Euler.

      Assim como a teoria dos grafos, os bancos orientado a grafos usam conceitos como nós, arestas e propriedades para representar e armazenar os dados. E cada elemento no banco possui um ponteiro direto para seu elemento adjacente.

      Se você trabalhou com modelo de objetos ou diagramas de entidade-relacionamento, o modelo orientado a grafos vai parecer familiar. O modelo orientado a grafos contém entidades conectadas (nós) que podem conter tipos e propriedades (pares de chave-valor) arbitrários. Os nós podem ser marcados com diferentes rótulos para representar suas diferentes regras de domínio. Além de contextualizar nós e propriedades de relacionamento, os rótulos dados servem também para anexar metadados ou informações de restrição, por exemplo, para nós.

Exemplo da construção modelo orientado a grafos
(Fonte: http://neo4j.com/developer/graph-database/)

      Os relacionamentos possuem direção, fazendo uma uma conexão semântica entre os nós. Uma relação tem sempre um sentido, um tipo, um nó de início, e um nó final. Assim como os nós, os relacionamentos podem ter propriedades arbitrárias. Na maioria dos casos, as relações têm propriedades quantitativas, como pesos, distâncias, classificações, intervalo de tempo ou pontos fortes. Como os relacionamentos são armazenados de forma eficiente, dois nós podem ter qualquer número ou tipo de relações entre eles sem secraficar o desempenho. E, embora os relacionamentos são direcionados, eles podem sempre ser navegados em ambos os sentidos.


Representação da estrutura dos dados orientado a grafos.
(Fonte: http://dev.assets.neo4j.com.s3.amazonaws.com/wp-content/uploads/2010/03/shop-categories-erd.png?_ga=1.52640488.1517740388.1415768885)

      Os principais banco de dados orientado a grafos atualmente, são: Neo4J, Horton, HyperGraphDB, AllegroGraph e Oracle Spatial and Graph.


Referências:

Graph database
Disponível em <http://en.wikipedia.org/wiki/Graph_database>. Acessado em 05/12/2014.

What is Graph database
Disponível em <http://neo4j.com/developer/graph-database/>. Acessado em 05/12/2014.

Whiteboard it - the power of graph databases
Disponível em <http://www.computerweekly.com/feature/Whiteboard-it-the-power-of-graph-databases>. Acessado em 05/12/2014.

Banco de dados MongoDB


(Fonte: http://www.mongodb.com/)


      Neste post iremos conhecer um pouco sobre o banco de dados NoSQL orientado a documentos mais popular no mercado, o MongoDB.

      O MongoDB foi projetado inicialmente pela empresa 10gen com o intuito ser um banco de dados orientado a documentos de sua plataforma de nuvem.  Após perceber o potencial do software, a 10gen decidiu cancelar sua plataforma de nuvem e se concentrar em manter o MongoDB. Em 2009, a 10gen converteu o MongoDB para um projeto de código aberto.

      Fazendo uma analogia com os banco de dados relacionais, a estrutura do MongoDB pode ser entendida da seguinte forma:

Comparação SQL e NoSQL
(Fonte: http://krishnasblog.com/2012/06/02/understanding-document-based-mongodb-nosql/)


      No MongoDB cada registro é realmente um documento. Os documentos são armazenados em um formato BSON (Binary Serializable JSON objects). E o MongoDB suporta consultas em JavaScript para recuperar os objetos BSON.  Os documentos BSON são objetos que contém uma lista ordenada de elementos salvos. E cada elemento é constituído por o nome do campo e um tipo específico de valor.

Exemplo de objeto no MongoDB
(Fonte: http://docs.mongodb.org/manual/core/data-model-design/)

      Algumas características positivas no MongoDB, são:

  • Consultas elabordas: Além de poder acessar os dados por meio de chaves, é possível fazer uma consulta em relação a campos especificados e variações dinamicamente na consulta, e também é possível consultar com expressões regulares.
  • Índice Secundário: Assim como pode-se fazer consultas em relação a campos especificados, pode também definir estes campos como índices secundários, para aumentar a performance de acesso ao dado.
  • Replicação Mestre-Escravo: Controla as operações de leitura e escrita para separar servidores, executando um servidor escravo como um servidor mestre quando o servidor mestre estiver inacessível.
  • Sharding: Possibilita o processo de armazenamento de registros de dados em vários servidores para atender as demandas de crescimento de dados.
  • MapReduce: Processa grandes volumes de dados em paralelo, dividindo o trabalho em um conjunto de tarefas independentes.
  • Suporte de drivers para várias linguagens de programação.

Referências:

Understanding document based MongoDB NoSQL
Disponível em <http://krishnasblog.com/2012/06/02/understanding-document-based-mongodb-nosql/>. Acessado em 04/12/2014.

NoSQL Concept and MongoDB
Disponível em <https://www.ma-no.org/en/content/index_nosql-concept-and-mongodb_1736.php>. Acessado em 04/12/2014.

What is MongoDB
Disponível em <http://www.mongodb.com/what-is-mongodb>. Acessado em 04/12/2014.

4 de dezembro de 2014

Redis, Um banco NoSQL Key/Value

Redis significa Remote Dictionary Server, é um banco NoSql do tipo Key/Value, tem licença BSD, sendo completamente livre de custos. Pode conter dados de diversos tipos como: strings, hashes, listas, conjuntos, bitmaps entre outros. Ou seja, apesar de ser do tipo Key/Value, o Redis destaca-se de outros por poder trata de valores mais complexos.

É escrito em ANSI C e funciona com a grande maioria dos sistemas POSIX, tais como Linux, BSD e OSX sem que seja necessária a instalação de quaisquer dependências externas. Não há suporte oficial para Windows, entretanto a Microsoft mantém um port para WIN-64 que pode ser encontrado aqui.

Fonte: http://blog.concretesolutions.com.br/wp-content/uploads/2013/01/redis-300dpi.png
Quanto ao uso de memória, seguem alguns números do Redis, por exemplo, uma instância vazia usa em torno de 1 MB, um milhão de pequenas chaves que guardem pares de strings, ocupará cerca de 100 MB, um milhão de chaves hash que representem um objeto com cinco campos, utilizará algo em torno de 200 MB.

Quanto aos limites, pode manejar até 232 chaves e já foi testado na prática com até 250 milhões de chaves, sem comprometimento de desempenho. É um banco de dados "in-memory", possui portanto alta velocidade de leitura e escrita, pode trabalhar em conjunto com outras bases de dados de armazenamento em disco, inclusive bases SQL.

O processo de salvar em disco ocorre em background, sempre que não houver comandos em execução no banco.


Referências:
redis.io - Acessado em 4/12/2014.

3 de dezembro de 2014

Banco de Dados NoSQL Orientado a Documentos

(Fonte: http://www.infoq.com/articles/Transition-RDBMS-NoSQL/)

      Como já vimos em posts anteriores, existem quatro tipos principais de modelo de dados NoSQL. São eles: Chave-Valor, Orientado a Documentos, Orientado a Colunas  e Orientado a Grafos.

      Neste post iremos nos focar nos banco de dados orientado a documentos.

      Um Banco de dados orientado a documentos é um projeto para armazenamento, recuperação e gerenciamento orientado a documentos ou semi-estruturas de dados.

      Os Banco de dados orientado a documentos são uma das principais categorias de banco de dados NoSQL. Um exemplo é o banco de dados MongoDB que é orientado a documentos e está em 5º lugar no ranking dos banco de dados mais populares segundo a DB-Engine.

(Fonte: http://www.bestonlinecourses.info/intro-to-nosql-and-mongodb/)

      Este modelo armazena uma coleção de documentos. No caso, um documento é representado como um objeto, que possui um código único e um conjunto de campos, que podem ser strings, listas ou outros objetos aninhados. 
Exemplo de uma tabela no modelo orientado a documentos
(Fonte: http://docs.couchbase.com/couchbase-devguide-2.0/)

      As estruturas desses campos se parecem com a estrutura dos campos no modelo Chave-valor (Key-value). No modelo Chave-valor, uma única tabela hash é criada para todo o banco de dados. Já no modelo orientado a documentos, temos um conjunto de documentos (objetos) e em cada documento temos um conjunto de chaves (campos) cada um com sua chave (key).


Modelo Chave-valor
(http://labs.sogeti.com/nosql-whats-in-it-for-me/)


Modelo Orientado a Documento
(Fonte: http://labs.sogeti.com/nosql-whats-in-it-for-me/)


      Uma característica importante deste modelo é que ele não depende de um esquema rígido, ou seja, não há obrigação de uma estrutura fixa. Sendo assim, pode-se fazer uma atualização na estrutura do documento sem causar nenhum problema com ao banco de dados. Por exemplo, a adição de novos campos ao documento não causará nenhum problema no banco. Essa facilidade e flexibilidade em atualizar a estrutura dos documentos é uma das grandes e principais vantagens do modelo orientado a documentos.

      Por mais que existam diferentes implementações de banco de dados orientado a documentos, em geral, todos assumem a função de encapsular documentos e codificar dados (ou informações) em algum formato padrão (ou codificação). As codificações em uso incluem XML, YAML, JSON e BSON, assim como formas binárias, como imagens, PDF, documentos do Microsoft Office (MS Word, Excel) e assim por diante.


Referências:

11 Open Document-Oriented Databases Wich comes under NoSQL DB Category!
Disponível em <http://orangeslate.com/2011/12/06/11-open-document-oriented-databases-which-comes-under-nosql-db-category/>. Acessado em 03/12/2014

DB Engines Ranking
Disponível em <http://db-engines.com/en/ranking>. Acessado em 03/12/2014.

NOSQL BASE X ACID TEOREMA CAP
Disponível em <http://pt.slideshare.net/Celio12/trabalho-no-sql-aricelio-de-souza?next_slideshow=3>. Acessado em 03/12/2014.

2 de dezembro de 2014

Cassandra - Modelo de Dados

    Já apresentamos uma visão geral do Projeto Apache Cassandra e agora iremos ver como é composto o modelo de dados para esses bancos. Iniciaremos esse post falando dos conceitos utilizados para isso.

    O modelo de dados faz uso de Column (coluna), SuperColumn (super coluna), ColumnFamily (família de colunas) e KeySpace (espaço chave), mas o que vem a ser cada item?

Column - unidade mais básica do modelo de dados, é composta por um trio de atributos: um nome, um valor e um relógio (clock). Diferente do modelo relacional não existe uma pré-definição, o nome e o valor são do tipo vetor de bytes, podendo variar em tempo de execução, já o relógio é do tipo timestamp.

SuperColumn - tipo especial de coluna que armazena um nome e um valor, sendo o valor um mapa de sub-colunas. Dessa maneira uma super coluna pode ter um número ilimitado de colunas, mas não pode armazenar outra super coluna.

ColumnFamily - espaço que contém uma coleção ordenada de linhas, onde para cada linha existe uma coleção ordenada de colunas. Eles são semelhantes as tabelas nos bancos de dados relacionais, mas sem ficar preso a uma estrutura pré definida.

KeySpce - recipiente mais externo aos dados, podendo ser associado a um banco de dados relacional, contendo um nome e um conjunto de atributos que definem seu comportamento. Uma aplicação pode conter mais de uma keyspace, mas é comum existir apenas uma por solução.


Fonte: http://www.datastax.com/docs/_images/cassandra_model.png

    Na figura temos o exemplo de um blog, por isso o keyspace dele é chamado de blog. As columnFamily são users, blog entries, subscribes_to, subscribers_of e time_ordered_blogs_by_user.

    Na columnFamily users temos a superColumn jbells, que possui uma column chamada name com valor jonathan e outra column chamada state com valor TX, o mesmo vale para dhutch (super coluna), já para egilmore vemos que só existe a coluna name, não havendo necessidade de outras colunas.

    Em um post futuro veremos como é feito a criação de um keyspace, bem como o preenchimento e as buscas.

Fonte: HEWITT, EBEN Título: Cassandra: The Definitive Guide, Primera Edição, Editora: O'Reilly Media Novembro de 2010.
      http://www.datastax.com/docs/1.0/ddl/about-data-model, acessado em 1 de dezembro de 2014;
      http://nivaldomjunior.blogspot.com.br/2010/07/entendendo-o-banco-de-dados-nosql.html, acessado em 1 de dezembro de 2014.